開発記録(第2回)。AI に日本株の売買判断をさせるシステムを個人で開発しています。全体像は目次記事にまとめています。
この記事の要点
- 東証の約3,800銘柄の日足(1日ごとの始値・高値・安値・終値・出来高)、適時開示、ニュースを、無料のデータ源だけで毎日集めています
- 日足は毎日「直近10営業日」を取り直し、株式分割や値のずれを見つけたら、その銘柄の全期間を取り直します
- 出来高0の日を欠損と数えていた、取得元が空を返す日がある、など5点でつまずきました
動作環境
| 項目 | 内容 |
|---|---|
| 言語 | Python 3.12 |
| 日足の取得 | yfinance 1.7.0、pandas 3.0 |
| ニュース | feedparser 6.0 |
| データベース | SQLite(SQLAlchemy 2.0) |
| 実行環境 | Windows の PC(毎日の自動実行は次回で扱います) |
やりたかったこと
売買の判断に使うデータを、毎日自動で集めて手元のデータベースに貯めることです。対象と取得元は次のとおりです。
| データ | 取得元 | 頻度 | 範囲 |
|---|---|---|---|
| 日足 | yfinance | 平日 16:30 | 東証プライム・スタンダード・グロースの内国株、約3,800銘柄。過去10年分 |
| 銘柄の一覧 | JPX の上場銘柄一覧(Excel) | JPX の月次の更新に合わせて | 同上 |
| 適時開示 | TDnet の適時開示情報閲覧サービス | 場中も30分ごと | 全上場企業 |
| ニュース | RSS(NHK、日本銀行、金融庁など) | 定期的に | 見出しと概要 |
データ源はすべて無料のものに限りました。有料のデータを使うかどうかは、システムで利益が出ることを確かめてから考えます。
なお、yfinance は Yahoo Finance の公式のライブラリではありません。取得したデータは個人での分析にだけ使っていて、このサイトの記事には株価の数値やチャートを載せていません。
手順
日足をまとめて取得する
yfinance の download に銘柄コードのリストを渡すと、複数の銘柄をまとめて取得できます。実際のコードは次のとおりです(Bar や split_by_ticker などの補助の定義は省略しています)。
import yfinance as yf

def download_daily(tickers: list[str], start: date, end: date) -> dict[str, list[Bar]]:
    """start〜end(両端を含む)の日足。取得できなかった銘柄は結果に含まれない。"""
    df = yf.download(
        tickers,
        start=start.isoformat(),
        end=(end + timedelta(days=1)).isoformat(),
        actions=True,
        auto_adjust=False,
        group_by="ticker",
        threads=False,
        progress=False,
        timeout=30,
        multi_level_index=True,
    )
    result: dict[str, list[Bar]] = {}
    for ticker, frame in split_by_ticker(df, tickers).items():
        bars = frame_to_bars(frame)
        if bars:
            result[ticker] = bars
    return result
引数のポイントは次のとおりです。
| 引数 | 指定 | 理由 |
|---|---|---|
tickers |
7203.T の形のリスト |
日本株は証券コードの後ろに .T を付ける |
end |
最終日の翌日 | end の日は結果に含まれないため |
auto_adjust |
False |
既定では配当も含めて調整した価格になる。分割だけ調整した終値(Close)と、配当も調整した終値(Adj Close)の両方を取るため、自動調整を止める |
actions |
True |
配当と株式分割の列も取る。分割の検知に使う |
threads |
False |
並列で取りに行かない。取得元に負荷をかけないため |
約3,800銘柄を50銘柄ずつに分け、1回ごとに1.5秒の間隔を空けて取得します。1日分の更新は76回の取得になります。
毎日の更新は「直近10営業日」を取り直す
毎日の更新では、その日の分だけでなく、直近10営業日分を取り直しています。取得元の値が後から修正されることや、株式分割で過去の価格が調整されることがあるためです。
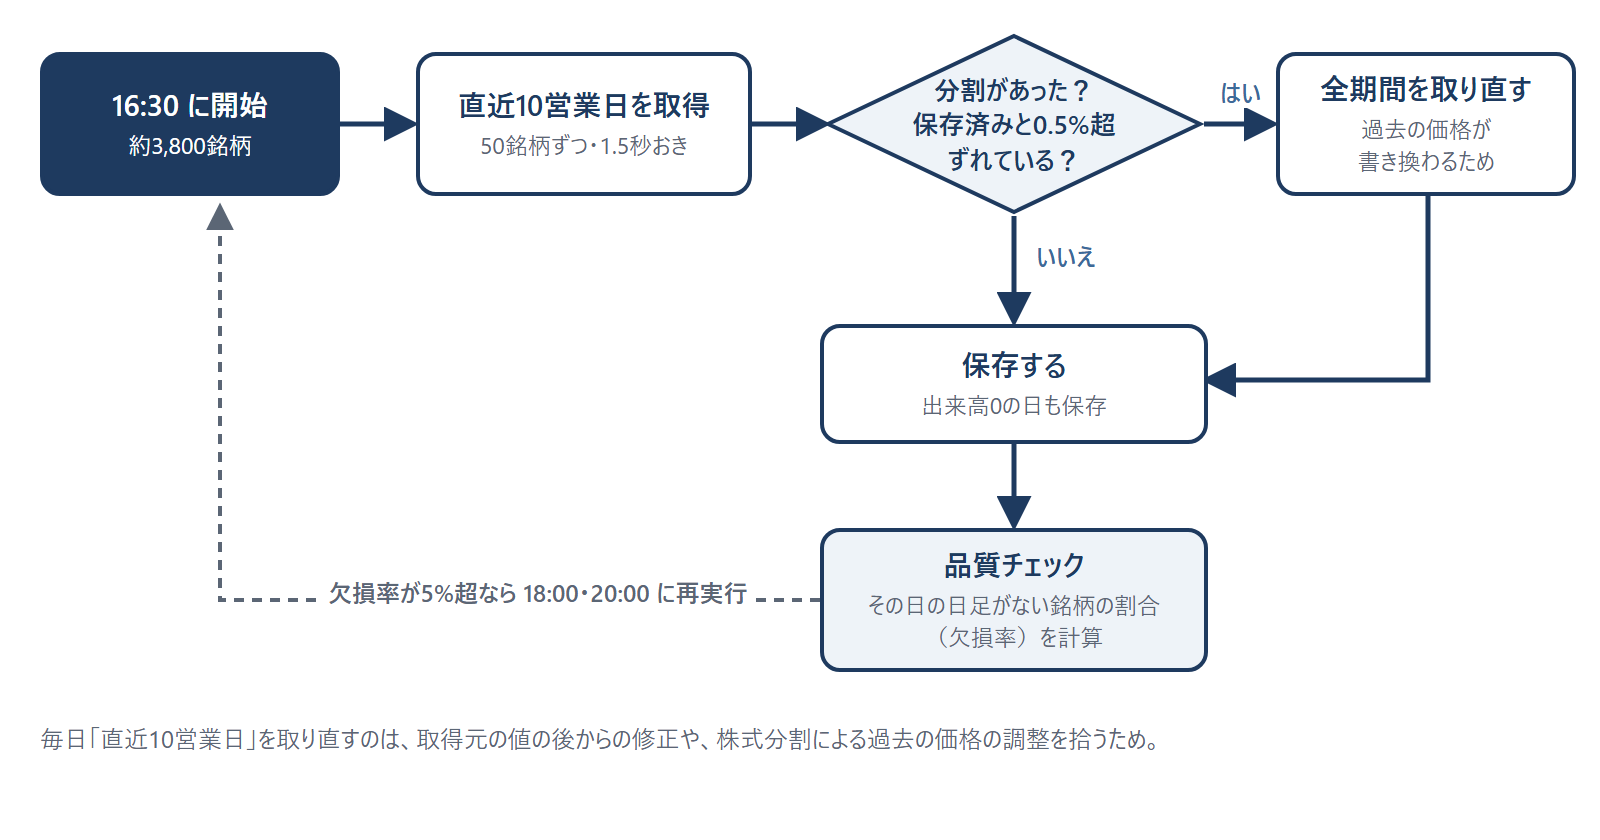
保存済みの終値とのずれは、次のように判定しています。
OVERLAP_TOLERANCE = 0.005  # 0.5%

def overlap_mismatch(stored: dict[date, Decimal], bars: Sequence[Bar]) -> bool:
    """保存済みの終値と取得した終値が食い違う(分割の後追い調整など)か。"""
    for b in bars:
        old = stored.get(b.trade_date)
        if old and old > 0 and abs(float(b.close) / float(old) - 1) > OVERLAP_TOLERANCE:
            return True
    return False
適時開示とニュース
適時開示は、TDnet の日別の一覧ページから、開示の時刻・会社・表題・PDF の場所を取得しています。本文の PDF は、ウォッチリストに入れた銘柄の分だけを保存しています。
ニュースは RSS を feedparser で取得しています。前回から更新がなければ取りに行かないようにし、URL から追跡用のパラメータを除いたうえで、同じ記事を二重に保存しないようにしています。
つまずいた点と解決
1. 出来高0の日を「欠損」と数えていた
運用を始めてすぐ、ある営業日の日足が47銘柄で欠けていると判定されました。30件を抜き出して調べると、28件は取得元にデータがあり、出来高が0の行(その日に売買が1件も成立しなかった)でした。
最初の実装は、出来高0の行を異常値として保存せずに捨てていました。流動性の低い銘柄では売買が成立しない日が毎日のようにあるため、この扱いのままでは「欠損率1%未満」という完成の条件を満たせません。過去10年分を見直すと、1,232銘柄・約12万日分が同じ理由で抜けていました。
出来高0の行も保存し、欠損としては数えないように直したうえで、過去分を取り直しました。「値がない日」と「売買が成立しなかった日」は別のものとして扱う必要がありました。
2. 株式分割で、過去の株価が書き換わる
yfinance の株価は、株式分割を調整した値で返ってきます。たとえば1株を2株に分割すると、分割より前の株価はすべて半分の値に書き換わります。分割前の実際の価格は取れません。
そのため、分割のあった銘柄は、保存済みの過去の値と、新しく取得した値が一致しなくなります。毎日の更新で分割(Stock Splits の列)を見つけたとき、または保存済みの終値と0.5%を超えてずれているときは、その銘柄の全期間を取り直すようにしました。
3. 取得元が空の値を返す日がある
運用の初期に、日足の欠損率が 99.84% になった日がありました。ほぼすべての銘柄で、取得元が空の値を返していました。時間を置いて取り直すと、値はそろいました。
yfinance は非公式のライブラリで、取得元の都合で取れない日があることを前提にする必要があります。次の3つで対処しています。
- 16:30 の取得の後に欠損率を計算し、5%を超えていれば 18:00 と 20:00 に自動で再実行する
- それでも欠損が多いときは、Discord に通知する
- 取得の処理は取得元ごとに分けて書き、yfinance が使えなくなったときに別の取得元へ差し替えられるようにする
4. TOPIX の指数そのものは取得しにくい
成績を比べる基準には TOPIX(東証株価指数)を使いたかったのですが、無料の取得元では指数そのものを安定して取れませんでした。そこで、TOPIX に連動する ETF(証券コード 1306)の値で代用しています。
ETF は信託報酬などのコストの分だけ指数とずれますが、「TOPIX に連動する商品を買って持ち続けた場合」との比較としては、むしろ実際に近い比べ方になります。
5. 適時開示は約1か月で見られなくなる
TDnet の適時開示情報閲覧サービスは、掲載期間が約1か月です。そのため、過去の開示をさかのぼってまとめて取得することはできません。適時開示のデータは、運用を始めた日からしか貯まりません。
重要な開示を後から読めなくならないよう、ウォッチリストの銘柄の開示は PDF を手元に保存しています。
無料のデータ源で集められないもの
つまずきとは別に、無料では手に入らないものもはっきりしました。
| 欲しかったもの | 無料で分かったこと | 対応 |
|---|---|---|
| 財務・過去データの補完 | J-Quants の無料プランは、データが約12週遅れる | 予備の取得元として位置づける |
| すべてのニュース | 無料の取得元だけでは網羅できない | 下の4層で見落としを減らす |
ニュースは「全部集める」ことをあきらめ、株価に影響する重要な情報を見落とさないことを目標にしました。
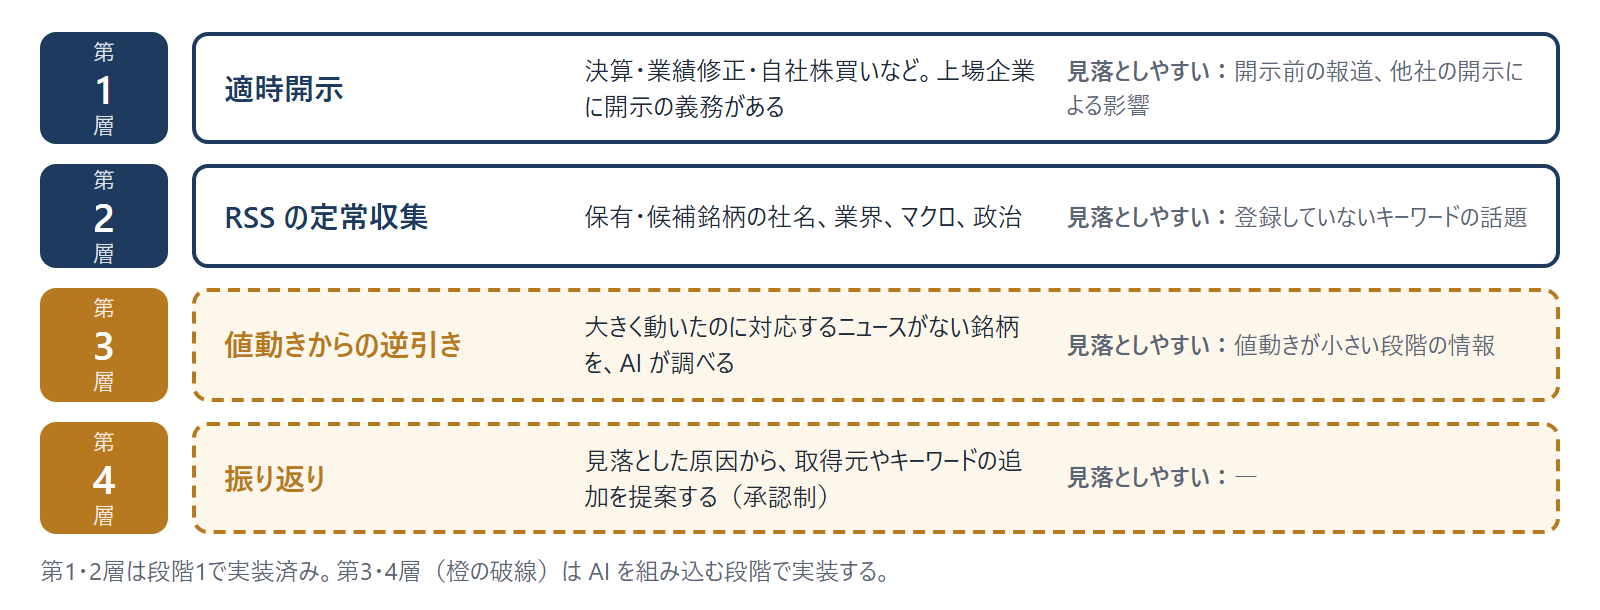
上場企業には、決算や業績の修正などを適時開示する義務があります。企業ごとの重要な情報は第1層でかなり拾えるため、ここを一番の土台にしています。
実際にどう使っているか
集めたデータは、毎日の品質チェックを通したうえで、次の用途に使っています。
- 毎日の銘柄の絞り込み(スクリーニング)
- 売買ルールの過去の検証(バックテスト)
- 画面でのチャートと開示・ニュースの表示
品質チェックでは、欠損率のほか、前日から ±50% を超えて動いた値(分割がないのに大きく動いたもの)や、高値が安値より低いといった矛盾も記録しています。
データの取得は、AI を使わない部分です。それでも、データが欠けたまま判断を出さないことが、後の AI の判断の質を左右すると考えています。
前回:AI の投資判断はバックテストできない|先読みバイアスと、先の相場で確かめる設計
次回:Windows のタスクスケジューラで Python のジョブを毎日動かす(準備中)
当サイトは情報提供を目的としており、投資助言を行うものではありません。掲載している売買記録は仮想売買(ペーパートレード)であり、実際の取引の結果ではありません。投資判断はご自身の責任で行ってください。詳しくは免責事項をご覧ください。